01
仓颉入门到实战
01-仓颉介绍
仓颉,这个名字来源于中国古代的神话人物,传说中是汉字的创造者。华为以此命名其编程语言,寓意深远——旨在创造一种全新的编程
Column · 栏目
60 篇文章 · 2026-08-26 ~ 2026-08-26
仓颉,这个名字来源于中国古代的神话人物,传说中是汉字的创造者。华为以此命名其编程语言,寓意深远——旨在创造一种全新的编程
本章节主要介绍如何搭建运行仓颉的开发环境。
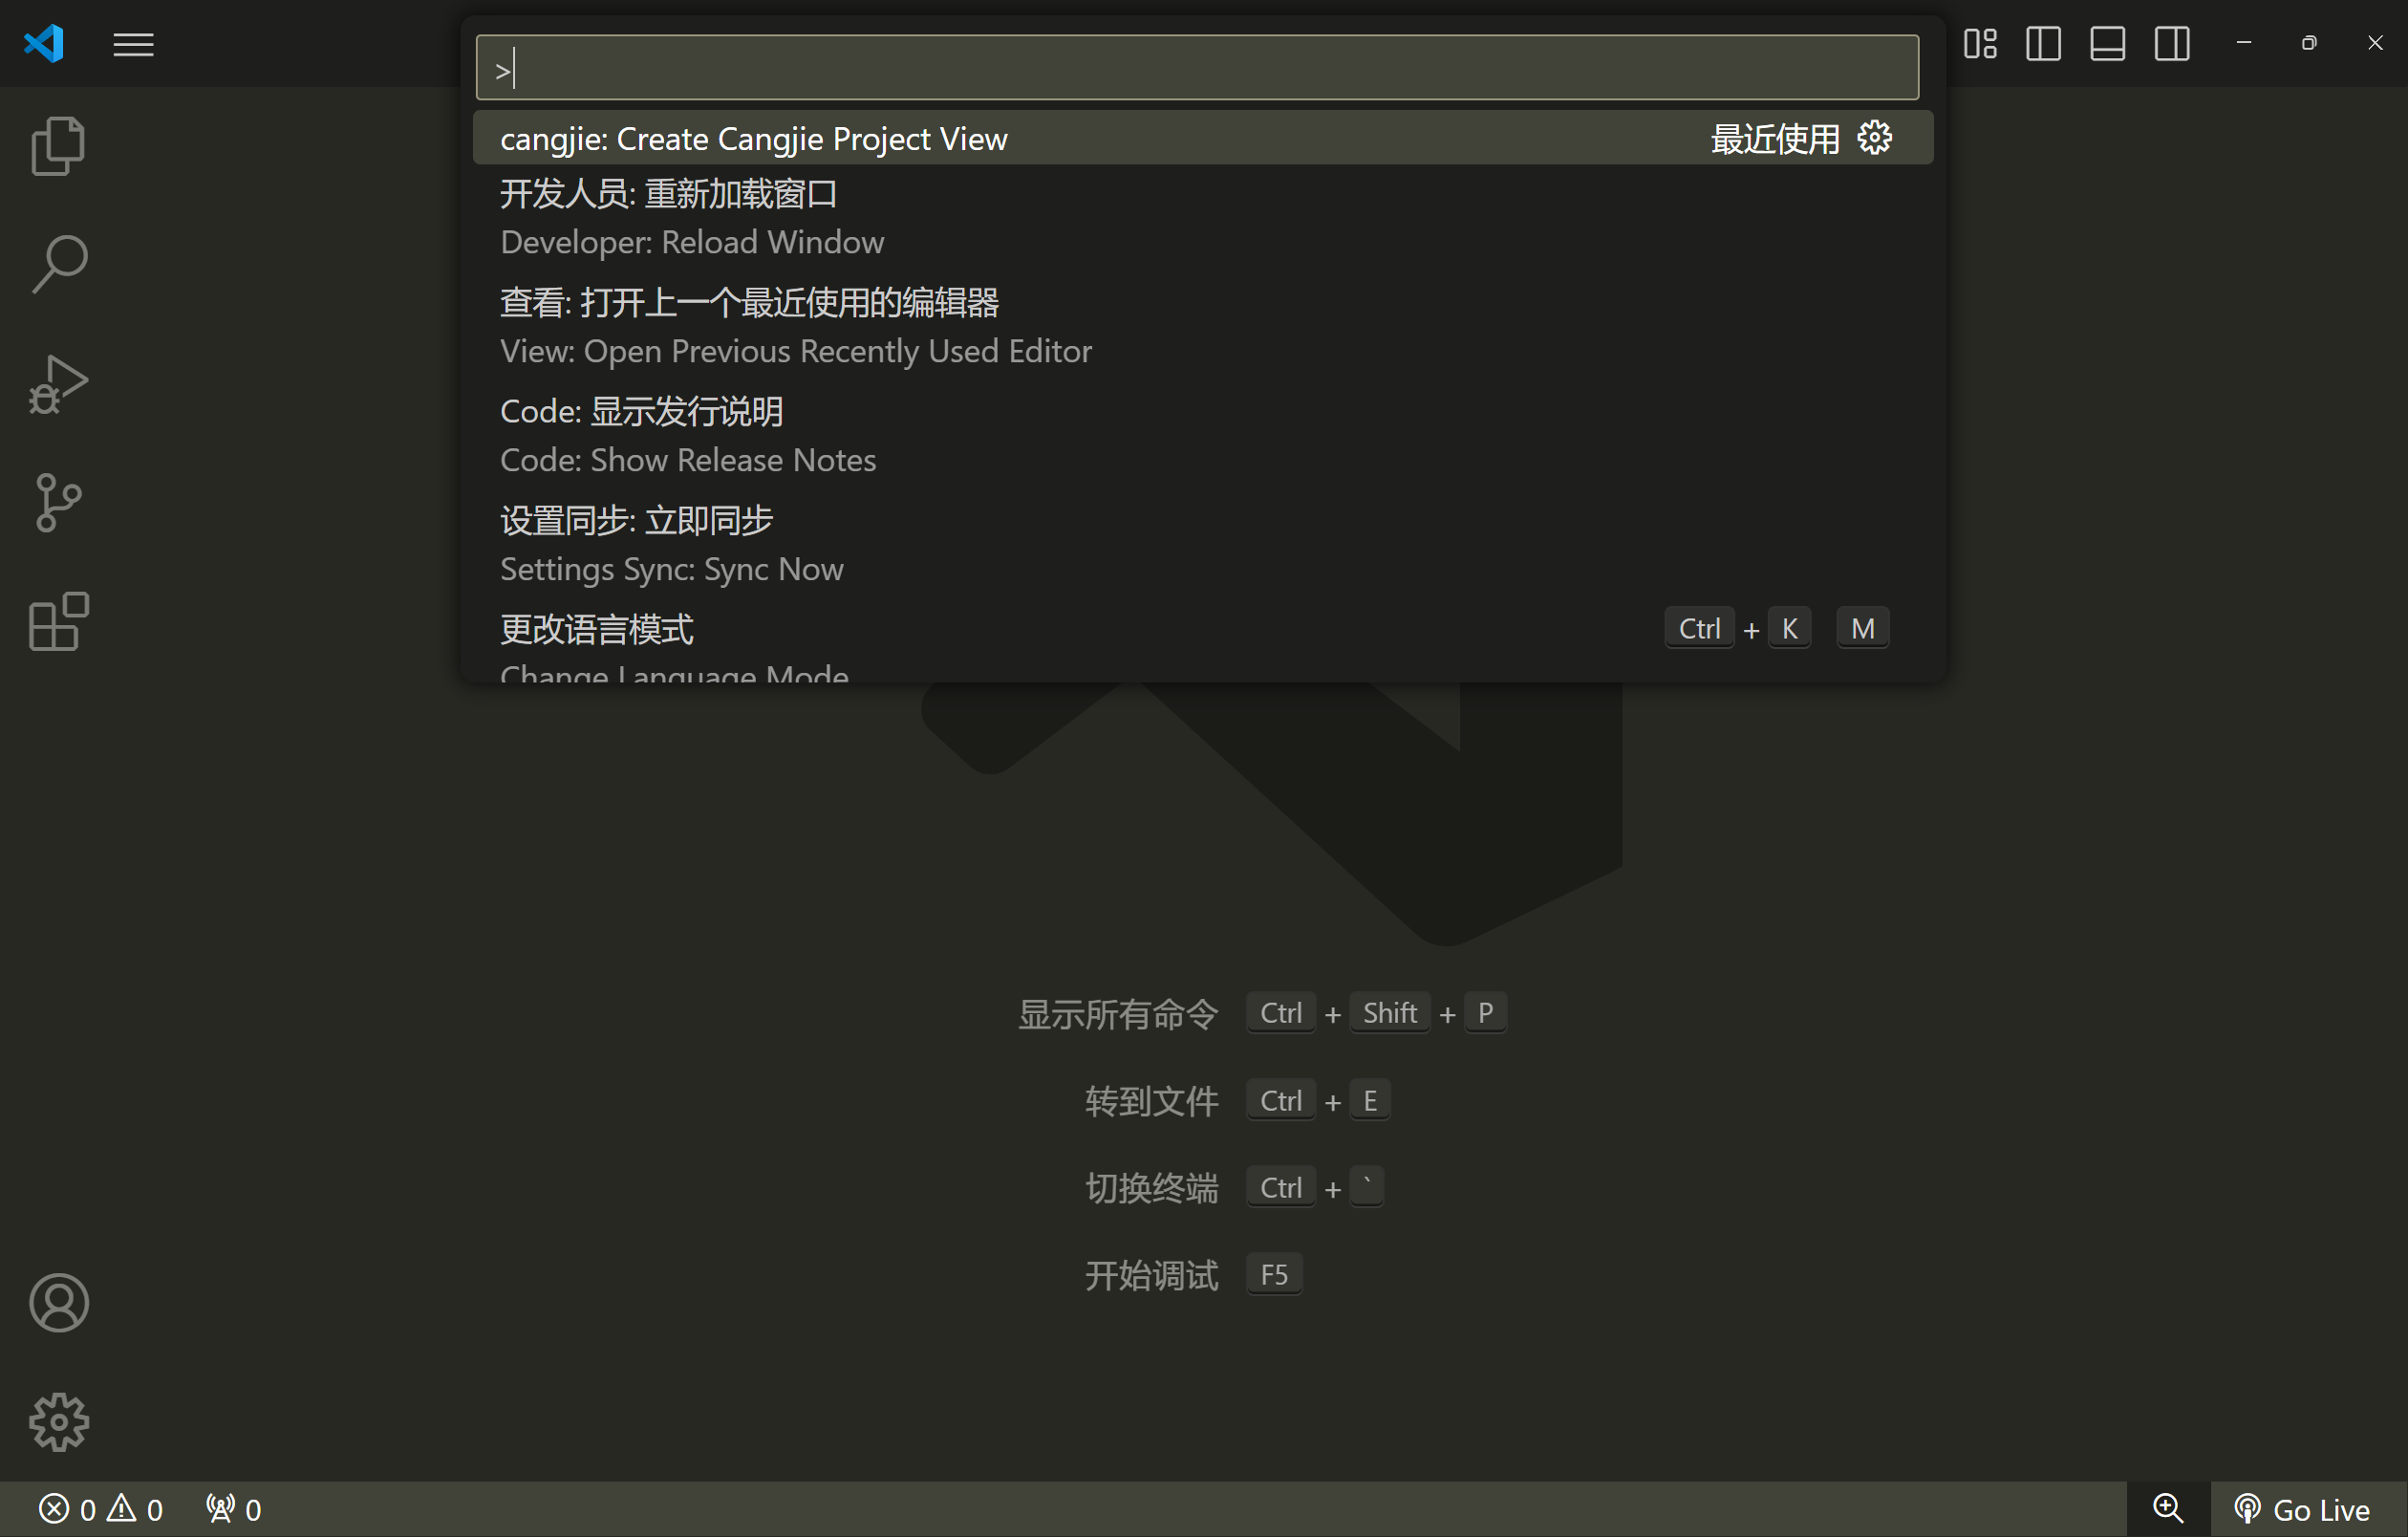
仓颉工程有自身的一些目录结构和文件命名等限制,如果不安装规范来,那么在开发时,语法提示等插件将无效。编译打包时,也将可能
在仓颉语言中,我们用到自定义的变量、函数、类等元素的名称,都必须用到标识符。我们可以也将刚才的变量、函数、类等看成是我们
在计算机编程的复杂体系中,变量可被精准地定义为计算机内存里专门用于存储数据的特定空间区域。当我们着手进行程序设计时,无论

在编程的世界中,很多情况下我们要操作的目标都是数据。比如仓库管理系统,需要通过数据来登记各种设备信息,航班管理系统,通过
整数字面量就是一眼能看出来是整数的字面的代码
浮点类型包括 Float16、 Float32 和 Float64,分别用于表示编码长度为 16-bit、 32-bit 和 64-bit 的浮点数(带小数部分的数
仓颉不支持不同类型之间的隐式转换(子类型天然是父类型,所以子类型到父类型的转换不是隐式类型转换),类型转换必须显式地进
布尔类型使用 Bool 表示,用来表示逻辑中的真和假。
字符类型使用 Rune /ruːn/ 表示,可以表示 Unicode 字符集中的所有字符。
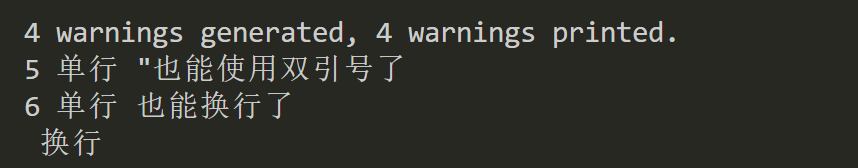
字符串类型使用 String 表示,用于表达完整文本数据,它的本质其实由一串 Unicode 字符组合而成。
数组类型使用Array来表示
除了引用类型的数组 Array,仓颉还引入了值类型数组 VArray
元组(Tuple)/ˈtjʊpəl; ˈtʌpəl/功能类似数组,都是管理一组数据,也是通过下标来获取元祖中的元素,但是也存在区别:
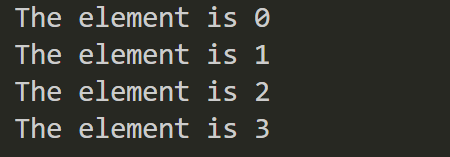
区间类型用于表示拥有固定步长的序列。作用是方便开发者获取一段特定范围的内容。它的用法包含三个值:
对于那些只关心副作用而不关心值的表达式,它们的类型是 Unit。例如,print 函数、赋值表达式、复合赋值表达式、自增和自减表达
函数是一些用于代码复用的集合,我们发现某些业务逻辑需要反复使用的时候便可以通过函数来实现。同时,函数也可以让复杂的程序结构按照功能的拆分,使程序更加的健壮合理。
仓颉编程语言中,函数是一等公民(first-class citizens),可以作为函数的参数或返回值,也可以赋值给变量。因此函数本身也有类型,
定义在源文件顶层的函数被称为全局函数。定义在函数体内的函数被称为嵌套函数。
Lambda表达式可以看成是一种函数的简写,对于函数而言,有函数声明、函数调用。所以我们在学习 Lambda表达式的时候也可以从这
闭包在仓颉编程中属于比较抽象的知识点。我们先来理解闭包的作用,然后再来学习的它的语法。
尾随 lambda 可以使函数的调用看起来像是语言内置的语法一样,增加语言的可扩展性。
在仓颉编程语言中,如果一个作用域中,一个函数名对应多个函数定义,这种现象称为函数重载。
操作符重载的意思是允许开发者根据自己的需求对常见的运算符赋予不同的能力。比如
常量求值允许某些特定形式的表达式在编译时求值,可以减少程序运行时需要的计算。本章主要介绍常量求值的使用方法与规则。
struct 类型的定义以关键字 struct 开头,后跟 struct 的名字,接着是定义在一对花括号中的 struct 定义体。struct
定义了 struct 类型后,即可通过调用 struct 的构造函数来创建 struct 实例。在 struct 定义之外,通过 struct 类型
mut 是 mutable的缩写,意思是 可变的
enum 类型提供了通过列举一个类型的所有可能取值来定义此类型的方式,比如:
Option 可以理解为是为我们常用的数据类型进行包装,包装的结果有两个:
因为 Option 类型可以同时表示有值和无值两种状态,而无值在某些情况下也可以理解为一种错误,所以 Option 类型也可以用作错
模式匹配主要是通过关键字 match匹配到合适的值,再去执行对应的内容。语法层面可以理解为很多编程语言中的switch-case
模式可以分为两类:refutable 模式和 irrefutable 模式
仓颉支持两种 match 表达式,第一种是包含待匹配值的 match 表达式,第二种是不含待匹配值的 match 表达式。
if-let 表达式首先对条件中 <- 右侧的表达式进行求值,如果此值能匹配 <- 左侧的模式,则执行 if 分支,否则执行 else 分支(可省略)。例如:
while-let 表达式首先对条件中 <- 右侧的表达式进行求值,如果此值能匹配 <- 左侧的模式,则执行循环体,然后重复执行此过程。如果模式匹配失败,则结束循环,继续执行 while-let 表达式之后的代码。例如:
模式除了可以在 match 表达式中使用外,还可以使用在变量定义(等号左侧是个模式)和 for in 表达式(for 关键字和 in 关键字之间是个模式)中。
class 类型是面向对象编程中的经典概念,仓颉中同样支持使用 class 来实现面向对象编程。class 与 struct 的主要区别在于:class 是引用类型,struct 是值类型,它们在赋值或传参时行为是不同的;class 之间可以继承,但 struct 之间不能继承。
仓颉不支持不同类型之间的隐式转换(子类型天然是父类型,所以子类型到父类型的转换不是隐式类型转换),类型转换必须显式地进行。下面将依次介绍数值类型之间的转换,Rune 到 UInt32 和整数类型到 Rune 的转换,以及 is 和 as 操作符。
在仓颉编程语言中,泛型指的是参数化类型,参数化类型是一个在声明时未知并且需要在使用时指定的类型。类型声明与函数声明
泛型可以用来定义泛型接口,以标准库中定义的 Iterable 为例,它需要返回一个 Iterator 类型,这一类型是一个容器的遍历器。 Iterator 是一个泛型接口,Iterator 内部有一个从容器类型中返回下一个元素的 next 成员函数,next 成员函数返回的类型是…
在仓颉编程语言中,泛型 enum 声明的类型里被使用得最广泛的例子之一就是 Option 类型了,关于 Option 详细描述可以详见 Option 类型章节。 Option 类型是用来表示在某一类型上的值可能是个空的值。这样,Option 就可以用来表示在某种类型上计算的失败。…
扩展可以为在当前 package 可见的类型(除函数、元组、接口)添加新功能。
扩展本身不能使用修饰符修饰。
仓颉中常用的几种基础 Collection 类型,包含 Array、ArrayList、HashSet、HashMap。
HashSet 类型来构造只拥有不重复元素的 Collection。Collection具有遍历元素、添加元素、删除元素,但是没有修改单个元素功能。
HashMap主要用来存储键值对数据, 是一种哈希表,提供对其包含的元素的快速访问。表中的每个元素都使用其键作为标识,可以使用键来访问相应的值。
前面已经了解过 Range、Array、ArrayList,它们都可以使用 for-in 进行遍历操作,那么对一个用户自定义类型,能不能实现类似的遍历操作呢?答案是可以的。
当项目规模持续扩张,在单个超大文件里管理源代码,就如同在杂乱无章的巨大仓库找一件小物品,难度极大。此时,将源代码依
仓颉中,可以使用访问修饰符来控制对类型、变量、函数等顶层声明的可见性。仓颉有 4 种访问修饰符:private、internal、protected、public,在修饰顶层元素时不同访问修饰符的语义如下。
在仓颉编程语言中,可以通过 import fullPackageName.itemName 的语法导入其他包中的一个顶层声明或定义,fullPackageName 为完整路径包名,itemName 为声明的名字。导入语句在源文件中的位置必须在包声明之后,其他声明或定义之前。例如:
仓颉程序入口为 main,源文件根目录下的包的顶层最多只能有一个 main。
异常是一类特殊的可以被程序员捕获并处理的错误,是程序执行时出现的一系列不正常行为的统称,例如,数组越界、除零错误、计算溢出、非法输入等。为了保证系统的正确性和健壮性,很多软件系统中都包含大量的代码用于错误检测和错误处理。
泛型约束的作用是在函数、class、enum、struct 声明时明确泛型形参所具备的操作与能力。只有声明了这些约束才能调用相应的成员函数。在很多场景下泛型形参是需要加以约束的。以 id 函数为例:
接口用来定义一个抽象类型,它不包含数据,但可以定义类型的行为。一个类型如果声明实现某接口,并且实现了该接口中所有的成员,就被称为实现了该接口。
属性(Properties)提供了一个 getter 和一个可选的 setter 来间接获取和设置值。
与其他面向对象语言一样,仓颉语言提供子类型关系和子类型多态。举例说明(不限于下述用例):
上文介绍了如何自定义异常,接下来学习如何抛出和处理异常。